

Как hh.ru создала «ИИ‑помощника», который оценивает 2 млн резюме в месяц
hh.ru — российская платформа онлайн-рекрутинга, где работодатели ищут сотрудников, а соискатели — работу. «ИИ-помощником» hh.ru уже воспользовались 20 тысяч компаний, а с соискателями он провел 6 млн диалогов.
TLDR
hh.ru встроил LLM-скоринг резюме в «ИИ-помощника» для работодателей: модель проверяет каждый отклик по критериям вакансии, выносит вердикт с дословной цитатой из резюме, а недостающую информацию уточняет в диалоге с кандидатом.
Результат: более 2 млн оценок резюме в месяц, около 7 тысяч подключенных вакансий и система отлова галлюцинаций.
Контекст: как в hh.ru работали с резюме до LLM
Работа рекрутера с откликами обычно выглядит так: он открывает каждое резюме, сверяет его с требованиями вакансии и решает, двигать ли соискателя дальше по воронке. Проблема в том, что на одну вакансию может прийти тысяча откликов: просмотреть все внимательно невозможно, внимание притупляется, ошибки накапливаются.
Поэтому скрининг в hh.ru давно автоматизирован: работают поиск по ключевым словам и классический ML, а сложные случаи рекрутеры разбирают вручную. Но у каждого подхода есть ограничения:
|
Подход |
Ограничения |
|
Поиск по ключевым словам |
Не видно синонимов, контекста и смежного опыта: «4 года опыта» и «нужно от 3 лет» для него разные строки. |
|
Классический ML |
Дорогая разметка, признаки плохо переносятся между профессиями, объяснимости нет. Новое требование — это датасет, обучение модели, эксперименты и повтор цикла. |
|
Ручной скрининг |
Не масштабируется на холодный поиск: тысячи кандидатов у тысяч вакансий, и всем нужно разное. |
Команда AI Lab начала смотреть в сторону LLM, потому что с помощью модели можно закрыть эти ограничения. AI-решение понимает семантику резюме и требований, объясняет вердикт цитатой из источника, а новое требование учитывает без дообучения — строкой в настройках. Так LLM-скоринг резюме стал частью «ИИ-помощника».
Задача: оценить резюме и уточнить то, чего в нем нет
Из резюме не всегда понятны детали опыта: кандидат мог не расписать инструменты, стаж по конкретному навыку или свою роль в проекте. Отклонять такой отклик сразу некорректно — подробные резюме выигрывали бы у кратких независимо от реального опыта. Поэтому недостающую информацию сервис уточняет у самого кандидата.
Скоринг и уточняющий диалог работают как один процесс: если резюме закрывает все критерии, работодатель сразу получает саммари, если нет — сервис задает кандидату вопросы и пересчитывает оценку с учетом ответов.
Решение: LLM‑вердикт по каждому критерию работодателя
Работодатель задает критерии оценки в «Портрете кандидата» — обязательные и желательные. Для специалиста по рекламе это, например, опыт в инфлюенс-маркетинге от 1 года, знание закона о рекламе и готовность работать в офисе.
По этим критериям сервис раскладывает отклики на три группы: «Подходят», «Можно рассмотреть» и «Не сейчас».
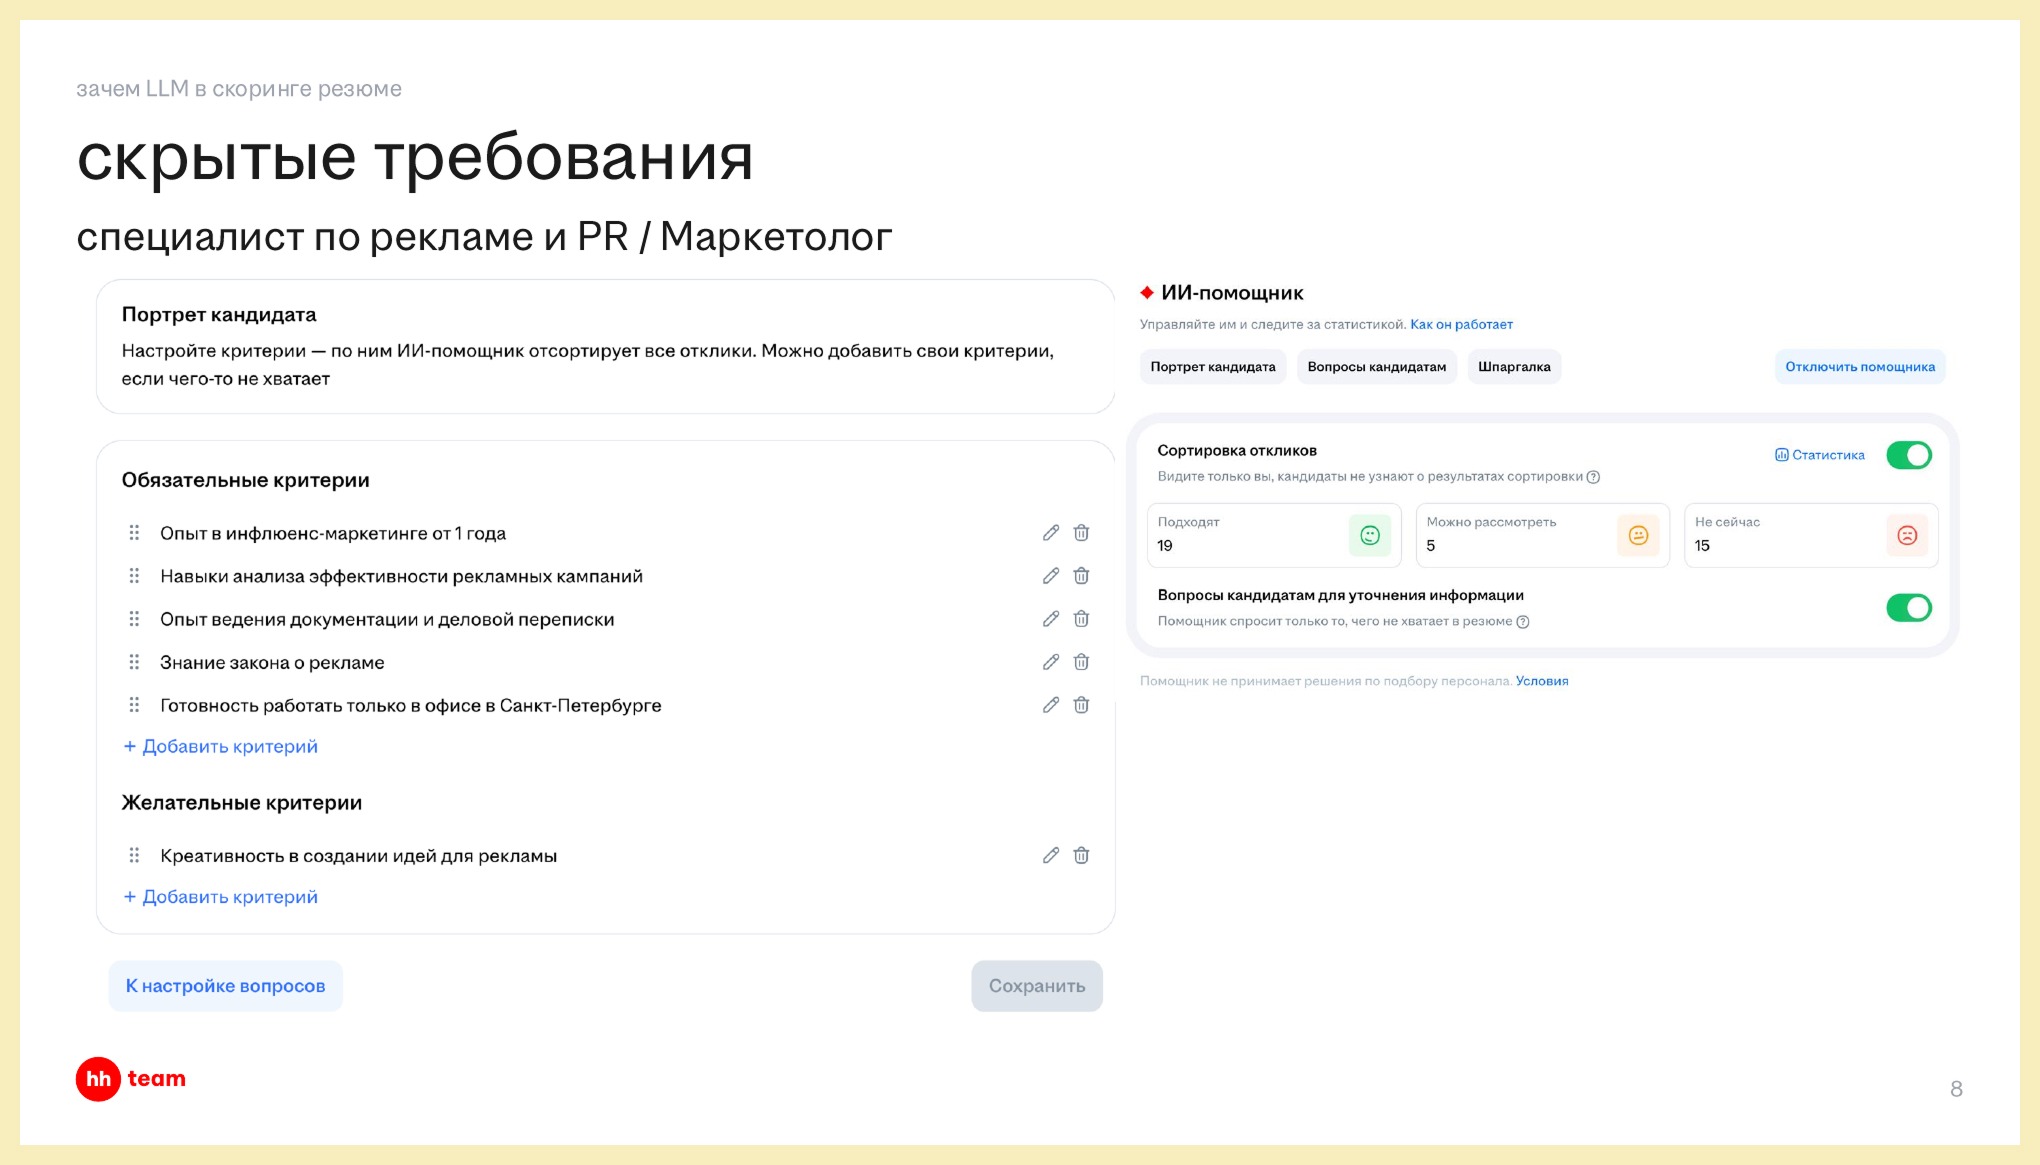
Интерфейс «Портрет кандидата» с критериями и сортировкой откликов на три группы
Внутри каждого отклика — разбор: вердикт по каждому критерию и объяснение, почему требование засчитано или нет. Финальное решение остается за рекрутером: помощник не принимает решений по подбору персонала.
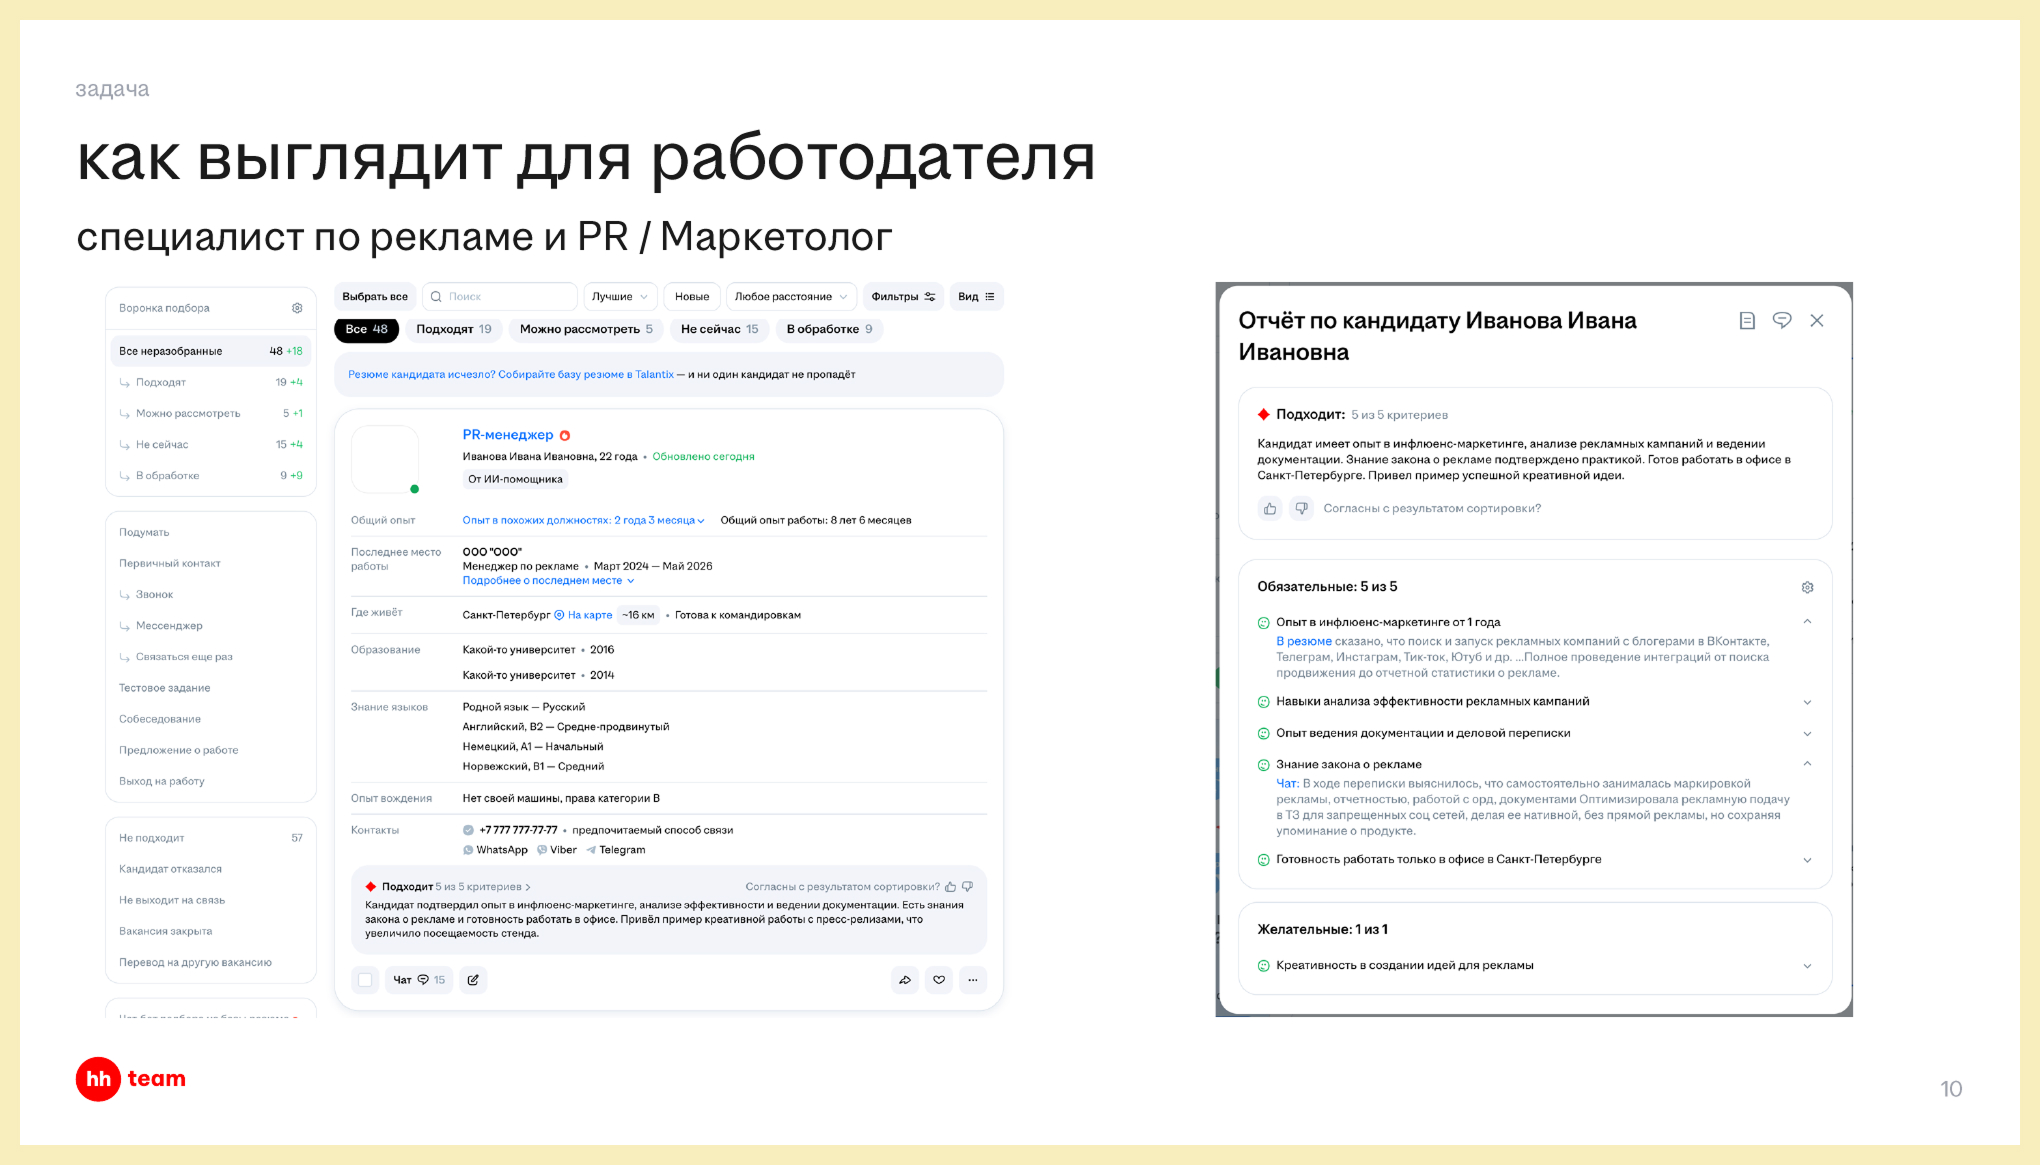
Отчет по кандидату: вердикт «Подходит: 5 из 5 критериев» с объяснениями по каждому требованию. Слайд 10 презентации hh.ru
Читайте также: как агентство «Есть контакт» закрывает вакансии с помощью AI-рекрутера за 8 дней вместо 20
Ядро скоринга: вердикт засчитывается только с дословной цитатой
На вход LLM получает резюме кандидата, критерии вакансии и, опционально, ответы кандидата в диалоге. На выходе — structured output: по каждому требованию генерируется фиксированный набор полей, а итоговое саммари по резюме укладывается в 50 слов. Ключевое поле схемы — дословная цитата.
|
Поле |
Что содержит |
|
criterion |
Само требование, например «уверенное знание Excel». |
|
is_met |
Вердикт: yes / partially / no — категории вместо балла 0–100. |
|
is_met_source |
Откуда взят вывод: resume или conversation. |
|
is_met_quote |
Дословная цитата без пересказа — защита от галлюцинаций. |
|
is_met_explanation |
Рассуждение: модель сначала объясняет, потом выносит вердикт — chain-of-thought поднимает точность. |
Исследования показывают, что у LLM встречается скрытая предвзятость: модель может выносить вердикт, не опираясь на данные резюме. Дословная цитата подтверждает, что информация о навыке в резюме действительно есть. Отдельно мы отлавливаем случаи, когда модель придумывает сам источник цитаты.
Архитектура «ИИ-помощника»
Схему оценки и уточняющий диалог держат три инфраструктурных компонента:
LangGraph
Граф состояний и оркестрация: скоринг и диалог работают как машина состояний.
PostgreSQL
Durable-checkpointer для LangGraph: диалог с кандидатом живет днями и переживает перезапуски.
Langfuse
Промпты и их версии, трейсинг каждого вызова, A/B-тесты и калибровка eval.
Путь запроса в проде выглядит так:
- Запрос: оркестратор присылает резюме, вакансию и критерии.
- Контекст: сервис собирает данные из внутренних бэкендов.
- PII-маска: имя кандидата маскируется до вызова модели.
- Граф: LangGraph вызывает модель через единый шлюз.
- Результат: structured output с вердиктами по критериям и цитатами.
- Очередь: результат уходит в очередь, потребитель забирает его оттуда.
Сейчас сервис делает более 2 млн оценок резюме в месяц. К LLM-скорингу подключено около 7 тысяч вакансий — доступ к функционалу расширяется поэтапно. За воспроизводимость отвечают зафиксированные seed и температура: прогоны по одному резюме должны сходиться.
Качество: что значит «знаю Excel» и как это проверить
После выхода в прод главный вопрос был таким: не стала ли автоматическая оценка хуже ручной. Проверить это сложно: строчка «знаю Excel» значит разное для кандидата и для нанимающего. Кандидат имеет в виду: открыть файл, посчитать сумму в столбце, построить простой график. Наниматель ждет: ВПР и XLOOKUP, сводные таблицы, формулы массивов, Power Query. Расхождение начинается уже на уровне одного навыка, поэтому качество оценки проверяют формальными методами.
Чтобы решить проблему, команда AI Lab сделала эвалы:
|
Что оцениваем |
Как |
Метрика |
|
Скоринг резюме |
Точное сравнение с эталоном: вердикт и источник сверяются по каждому критерию на датасете со сложными пограничными примерами. |
Доля пройденных проверок. |
|
Диалог с кандидатом |
Сравнение по смыслу: близость реплик к эталонным формулировкам через многоязычную векторную модель. |
Векторная близость на наборе диалоговых кейсов. |
Ручная разметка плохо масштабируется, поэтому поверх обеих методологий работает LLM-судья с таксономией из восьми ошибок и калибровкой в пять шагов.
Ошибки: что не сработало
За время разработки команда отказалась от четырех подходов:
- Наивный промпт «оцени резюме». Один промпт без схемы и критериев работает нестабильно и не дает источника вывода.
- Балл вместо категорий. Шкала 0–100 хрупкая, непрозрачная и необоснованная — на смену пришли yes / partially / no.
- Ставка на более сильную модель. Мощная модель не заменяет методологию: критерии и схему оценки все равно нужно продумывать.
- Погоня за 100% совпадением с экспертами. Эксперты сами расходятся во мнении, цель — достаточно качественный сигнал, который удовлетворит большинство.
Есть и ограничение: LLM-скоринг медленнее и дороже прежних ML-моделей — ответ занимает секунды вместо миллисекунд, и каждый вызов стоит токенов. Выигрывает он там, где рекрутеру нужны объяснения и где требования меняются быстрее, чем успевает цикл переобучения.
Ключевые результаты проекта
2 млн+
Оценок резюме в месяц проходит через LLM-скоринг в проде.
~7 тысяч
Вакансий подключено к скорингу — доступ расширяется поэтапно.
6 млн
Диалогов с соискателями провел «ИИ-помощник» hh.ru, им воспользовались 20 тысяч компаний.
Главное
hh.ru встроил LLM-скоринг резюме в «ИИ-помощника» и довел его до 2 млн+ оценок в месяц. Вердикт по каждому критерию засчитывается только с дословной цитатой из резюме, недостающую информацию сервис уточняет у кандидата в диалоге, а качество контролирует LLM-судья, откалиброванный на разметке рекрутеров.
Без структурной оценки поток в тысячу откликов рекрутер физически не досматривает: подходящие кандидаты теряются в глубине списка, а единственный сигнал проблемы — вакансия, которая остается незакрытой при сотнях необработанных откликов.
Если вы думаете о внедрении LLM-оценки в свои процессы, команда Just AI помогает пройти путь от задачи до пилота


